Mã số N2059: Giải pháp nền tảng trợ lý AI và quản trị tri thức chuyên ngành phục vụ cơ quan nhà nước, doanh nghiệp

Hệ thống văn bản, quy trình và biểu mẫu thủ tục hành chính hiện nay có khối lượng lớn và phân tán đa định dạng, khiến người dân, doanh nghiệp và công chức mất nhiều thời gian tra cứu, đối chiếu. Thông tin trên các cổng dịch vụ công khó tìm kiếm, quy trình gồm nhiều bước phức tạp yêu cầu hiểu đúng hồ sơ và cơ quan xử lý, trong khi hệ thống hỗ trợ trực tuyến theo thời gian thực còn hạn chế. Ngoài ra, các chatbot hiện hữu phần lớn hoạt động theo kịch bản cố định, thiếu tính linh hoạt và khả năng xử lý các câu hỏi phức tạp.
Từ thực tiễn đó, việc phát triển một nền tảng trợ lý AI kết hợp quản trị tri thức chuyên ngành là cần thiết, nhằm chuyển đổi nguồn tài liệu phân tán thành hệ thống tri thức có cấu trúc, hỗ trợ tra cứu thông minh, cung cấp câu trả lời có căn cứ và nâng cao hiệu quả xử lý công việc. Giải pháp hướng đến khả năng ứng dụng linh hoạt trong cơ quan nhà nước và doanh nghiệp, không chỉ phục vụ tra cứu thủ tục hành chính mà còn hỗ trợ khai thác tri thức, quy trình nghiệp vụ và tài liệu chuyên môn theo nhu cầu thực tế.
Giải pháp ứng dụng Mô hình ngôn ngữ lớn (LLM) kết hợp cùng kỹ thuật Truy xuất tăng cường (RAG) và Đồ thị Tri thức (Knowledge Graph - KG) để xây dựng hệ thống trợ lý ảo phục vụ quản lý nhà nước. Điểm mới cốt lõi là việc ứng dụng hệ thống đa tác nhân tích hợp các thuật toán tiên tiến như Adaptive-RAG (phân loại độ phức tạp câu hỏi để quyết định truy xuất) và Corrective-RAG (đánh giá và tự động sửa lỗi thông tin truy xuất bằng tìm kiếm web) nhằm đảm bảo câu trả lời có căn cứ xác thực và giảm thiểu rủi ro sinh thông tin sai lệch (hallucination). Hệ thống còn tích hợp đa phương thức bao gồm nhận dạng giọng nói tự lưu trữ (STT), nhận diện ký tự quang học (OCR) xử lý văn bản đa định dạng và dịch thuật đa ngôn ngữ.
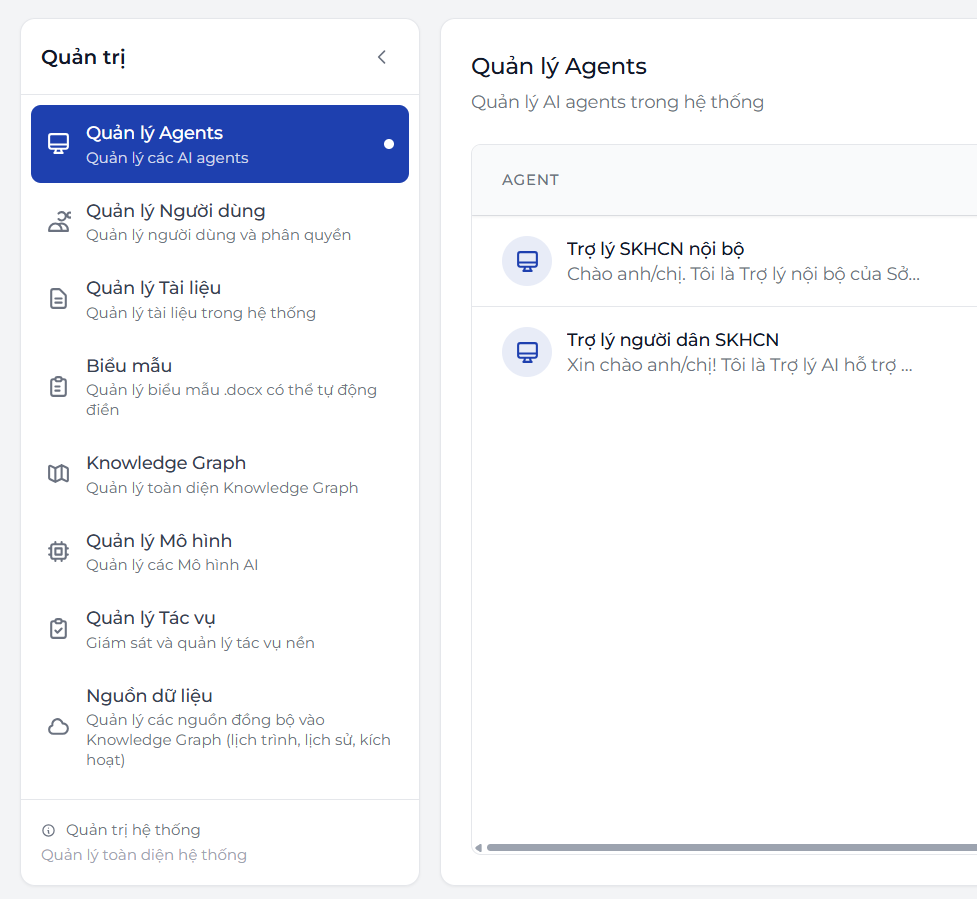
Hệ thống chatbot
Bản chất của giải pháp không phải là một chatbot giao tiếp theo kịch bản (rule-based) đơn giản, mà là một Hệ sinh thái Trợ lý ảo sử dụng AI tạo sinh (Generative AI) tích hợp Đa tác nhân (Multi-Agent). Hệ thống được xây dựng và thiết kế theo một khung kiến trúc pipeline 5 bước tinh vi, giải quyết triệt để bài toán "ảo giác" (hallucination) thường gặp ở các mô hình ngôn ngữ lớn (như ChatGPT khi tự bịa ra thông tin pháp luật không có thật).
Cụ thể, kiến trúc của hệ thống bao gồm:
Module Adaptive (Thích ứng): Tích hợp LLM để dự đoán và phân loại độ phức tạp của câu hỏi người dùng (truy vấn đơn giản, truy vấn cần tìm kiếm thông tin, truy vấn phức tạp). Nhờ đó hệ thống điều tiết tài nguyên xử lý tối ưu nhất.
Module Retrieval (Truy xuất): Không chỉ sử dụng cơ sở dữ liệu Vector thông thường (Vector Database), hệ thống còn kết hợp Đồ thị Tri thức (Knowledge Graph - KG) để truy xuất lai (Hybrid Search). Điều này giúp hệ thống tìm kiếm thông tin dựa trên quan hệ cấu trúc nội tại của các văn bản pháp luật.
Module Corrective (Chỉnh sửa): Sử dụng bộ đánh giá truy xuất (Retrieval Evaluator) để phân loại thông tin tìm được thành 3 mức: Correct (Chính xác), Incorrect (Không chính xác) và Ambiguous (Mơ hồ). Nếu tài liệu không liên quan, hệ thống sẽ loại bỏ và tự động kích hoạt API tìm kiếm web bên ngoài để bổ sung kiến thức.
Module Generate (Tạo sinh): Kết hợp câu hỏi và các tài liệu đã được tinh lọc để LLM (sử dụng các mô hình mạnh mẽ như Mixtral 8x22B, Llama-2 được tinh chỉnh tiếng Việt) tổng hợp ra câu trả lời tự nhiên, dễ hiểu nhất.
Module Self-reflection (Tự đánh giá): Đánh giá chéo lại câu trả lời vừa tạo ra. Nếu phát hiện câu trả lời không hữu ích hoặc có dấu hiệu bịa đặt thông tin, hệ thống sẽ tự động quay lại bước truy xuất để làm lại quá trình, đảm bảo dữ liệu đưa ra 100% an toàn và chính xác trước khi hiển thị cho người dùng.
Điểm sáng tạo công nghệ:
Thành phần / Kỹ thuật | Phân tích giá trị khác biệt và Tính sáng tạo |
Mô hình Adaptive-RAG | Ứng dụng mô hình Llama-2 (3B tham số) được fine-tune chuyên biệt để đóng vai trò 'người gác cổng' phân loại câu hỏi (Classifier). Mô hình này đạt độ chính xác (Accuracy) cực kỳ ấn tượng lên tới 0,9593 và Macro F1-score 0,9592, giúp hệ thống biết chính xác khi nào cần truy cập kho dữ liệu nội bộ, khi nào có thể trả lời trực tiếp, tiết kiệm đáng kể tài nguyên máy chủ và giảm thời gian phản hồi. |
Mô hình Corrective-RAG | Đây là đột phá giúp AI của chính quyền luôn trả lời ĐÚNG. Với Accuracy đạt 0,8086, khi phát hiện tài liệu nội bộ trả về có tính chất 'Mơ hồ' hoặc 'Sai', hệ thống tự động kích hoạt Web Search (tìm kiếm trên internet) để lấy thông tin mới nhất bổ sung. Kỹ thuật Knowledge Refinement (Sàng lọc kiến thức) sẽ chia nhỏ tài liệu, loại bỏ nhiễu và chỉ giữ lại những mảnh kiến thức (chunks) đắt giá nhất. |
Đồ thị Tri thức đa chiều (Knowledge Graph - KG) | Thay vì chỉ lưu trữ văn bản dạng chữ, hệ thống xây dựng mạng lưới tri thức với 7 loại nút (folder, file, section, chunk, image, table, sheet) và 9 loại cạnh liên kết (parent, child, next, embedding, BM25, keyword, concept, reference, supersedes). Đồ thị này lưu trữ khoảng 10.879 nút và 1.125.606 quan hệ, đạt điểm chất lượng tổng hợp 93,4/100. Kỹ thuật này giúp AI hiểu được sơ đồ tổ chức văn bản hành chính, xử lý dễ dàng các dạng bảng biểu, danh sách gạch đầu dòng mà các AI thông thường thường bó tay. |
Khả năng sinh văn bản hành chính chuẩn mực | Không chỉ dừng ở hỏi đáp, hệ thống tích hợp Module tạo sinh văn bản hành chính xuất ra các định dạng chuẩn (DOCX/PDF). AI có thể tự động viết Thông báo, Công văn, Kế hoạch, Biên bản, Báo cáo tổng kết, Tham luận. Độ chính xác định dạng đạt >90%, chất lượng nội dung đạt các chỉ số NLP rất cao (ROUGE-1 > 0,85; BERTScore > 0,85). Tốc độ tạo văn bản dài phức tạp chỉ mất tối đa 90 giây. |
Tích hợp Đa phương thức (Multimodal) nội bộ | Dự án làm chủ và tự triển khai (self-hosted) các mô hình nhận dạng tiên tiến nhất ngay trên máy chủ cục bộ: STT (Qwen3-ASR-1.7B) đạt tỷ lệ lỗi từ (WER) thấp kỷ lục 5,83%; OCR (ChandraOCR 9B) để đọc hiểu ảnh chụp văn bản, hồ sơ bản cứng với điểm benchmark 83,1. Điều này giúp hệ thống xử lý hồ sơ hình ảnh, giọng nói mà không phải gửi dữ liệu ra bên ngoài (đảm bảo an ninh thông tin tuyệt đối). |
Điểm khác biệt so với các giải pháp chatbot hiện hành:
Tiêu chí | Các Chatbot hành chính công hiện có | Hệ thống Trợ lý ảo AI Quản lý nhà nước (Dự án) |
Kiến trúc cốt lõi | Sử dụng kịch bản (Rule-based) hoặc so khớp từ khóa (Keyword matching). Thường không hiểu được câu hỏi sai chính tả hoặc câu hỏi dài phức tạp. | Sử dụng Mô hình ngôn ngữ lớn (LLM) kết hợp Đồ thị tri thức (KG) và truy xuất Adaptive-RAG. Hiểu ngôn ngữ tự nhiên, suy luận logic chuyên ngành vượt trội. |
Kiểm soát chất lượng thông tin | Trả lời dựa trên kịch bản cứng, nếu thông tin ngoài kịch bản thì không trả lời được. Dễ bị lạc hậu khi luật thay đổi. | Có cơ chế Corrective-RAG tự động đánh giá độ tin cậy của tài liệu. Nếu luật mới thay đổi chưa cập nhật, hệ thống tự động cảnh báo hoặc tìm kiếm thêm trên web. |
Hỗ trợ tác nghiệp cán bộ | Không có. Thường chỉ hướng tới người dân. | Hỗ trợ cán bộ cực kỳ mạnh mẽ: Tự động tổng hợp báo cáo, viết tham luận, tạo công văn theo mẫu chuẩn quốc gia, trích xuất dữ liệu từ bảng biểu. |
Tích hợp hệ thống & Đa phương thức | Chỉ giao tiếp bằng tin nhắn văn bản. Khó tích hợp với các phần mềm CRM hoặc cổng dịch vụ công. | Cung cấp API chuẩn OpenAI-compatible, GraphQL, WebSocket. Hỗ trợ giao tiếp bằng giọng nói (Voice), nhận diện ảnh chụp hồ sơ (OCR), dịch thuật đa ngôn ngữ. |
Lợi ích cho người dùng: Value Proposition Canvas
Để thấu hiểu sâu sắc nhu cầu của người dùng cuối, chúng tôi đã tiến hành khảo sát và phân tích giá trị mang lại dựa trên mô hình Value Proposition Canvas:
Thành phần Phân tích | Chi tiết cho Người Dân / Doanh Nghiệp | Chi tiết cho Cán bộ / Công chức |
Customer Jobs (Nhiệm vụ cần làm) | - Tìm hiểu quy định pháp lý, hồ sơ thủ tục hành chính. | - Tiếp dân, hướng dẫn thủ tục. |
Pains (Nỗi đau / Khó khăn) | - Văn bản luật chồng chéo, ngôn ngữ hành chính hàn lâm khó hiểu. | - Quá tải do phải trả lời những câu hỏi lặp đi lặp lại. |
Gains (Mong muốn / Kỳ vọng) | - Có người hướng dẫn tận tình, giải thích dễ hiểu. | - Có công cụ tìm kiếm nội bộ thông minh, chính xác tuyệt đối. |
Cách Giải pháp (Value Map) đáp ứng trọn vẹn nhu cầu:
Thành phần Giải pháp | Phân tích giá trị tạo ra |
Products & Services | Hệ thống cung cấp 2 giao diện chuyên biệt: Chatbot DVC nhúng trên cổng thông tin công cộng và Chatbot CCVC hoạt động trên mạng nội bộ bảo mật. |
Pain Relievers (Giảm đau) | Hệ thống AI 'phiên dịch' ngôn ngữ luật khô khan thành lời giải thích thân thiện, dễ hiểu. Công cụ tạo sinh văn bản (Text Generation) tự động viết báo cáo chuẩn form, loại bỏ hoàn toàn quá trình copy-paste thủ công mệt mỏi của công chức. |
Gain Creators (Tạo giá trị) | Cung cấp ngay đường link tải đúng biểu mẫu cần thiết. Hỗ trợ người yếu thế bằng tính năng hỏi đáp bằng giọng nói. Môi trường làm việc của công chức trở nên thông minh hơn, mọi quyết định đều được AI cung cấp căn cứ pháp lý rõ ràng, trích dẫn chính xác số hiệu văn bản. |
+ Độ tin cậy và tính pháp lý cao nhất: AI không bao giờ trả lời chung chung. Mọi tư vấn đưa ra đều kèm theo trích dẫn chính xác nguồn văn bản pháp quy (số hiệu, ngày ban hành, điều khoản cụ thể). Điều này đặc biệt quan trọng trong lĩnh vực quản lý nhà nước, nơi mọi sai sót đều có hậu quả pháp lý.
+ Nâng cao hình ảnh cơ quan công quyền: Cơ quan ứng dụng công nghệ này sẽ ngay lập tức ghi điểm trong mắt người dân nhờ sự hiện đại, minh bạch và tính sẵn sàng phục vụ 24/7. Điều này giúp cải thiện trực tiếp các chỉ số đánh giá cấp quốc gia (PAR Index, SIPAS, DTI).
+ Tính bảo mật và làm chủ dữ liệu (Data Sovereignty): Không giống việc dùng ChatGPT hay các AI thương mại khác có nguy cơ rò rỉ dữ liệu quốc gia ra máy chủ nước ngoài, hệ thống của chúng tôi được thiết kế để triển khai On-Premises (ngay tại máy chủ cục bộ của cơ quan), với kiến trúc cô lập dữ liệu và mã hóa AES-256 cao cấp, đảm bảo an ninh mạng tuyệt đối.
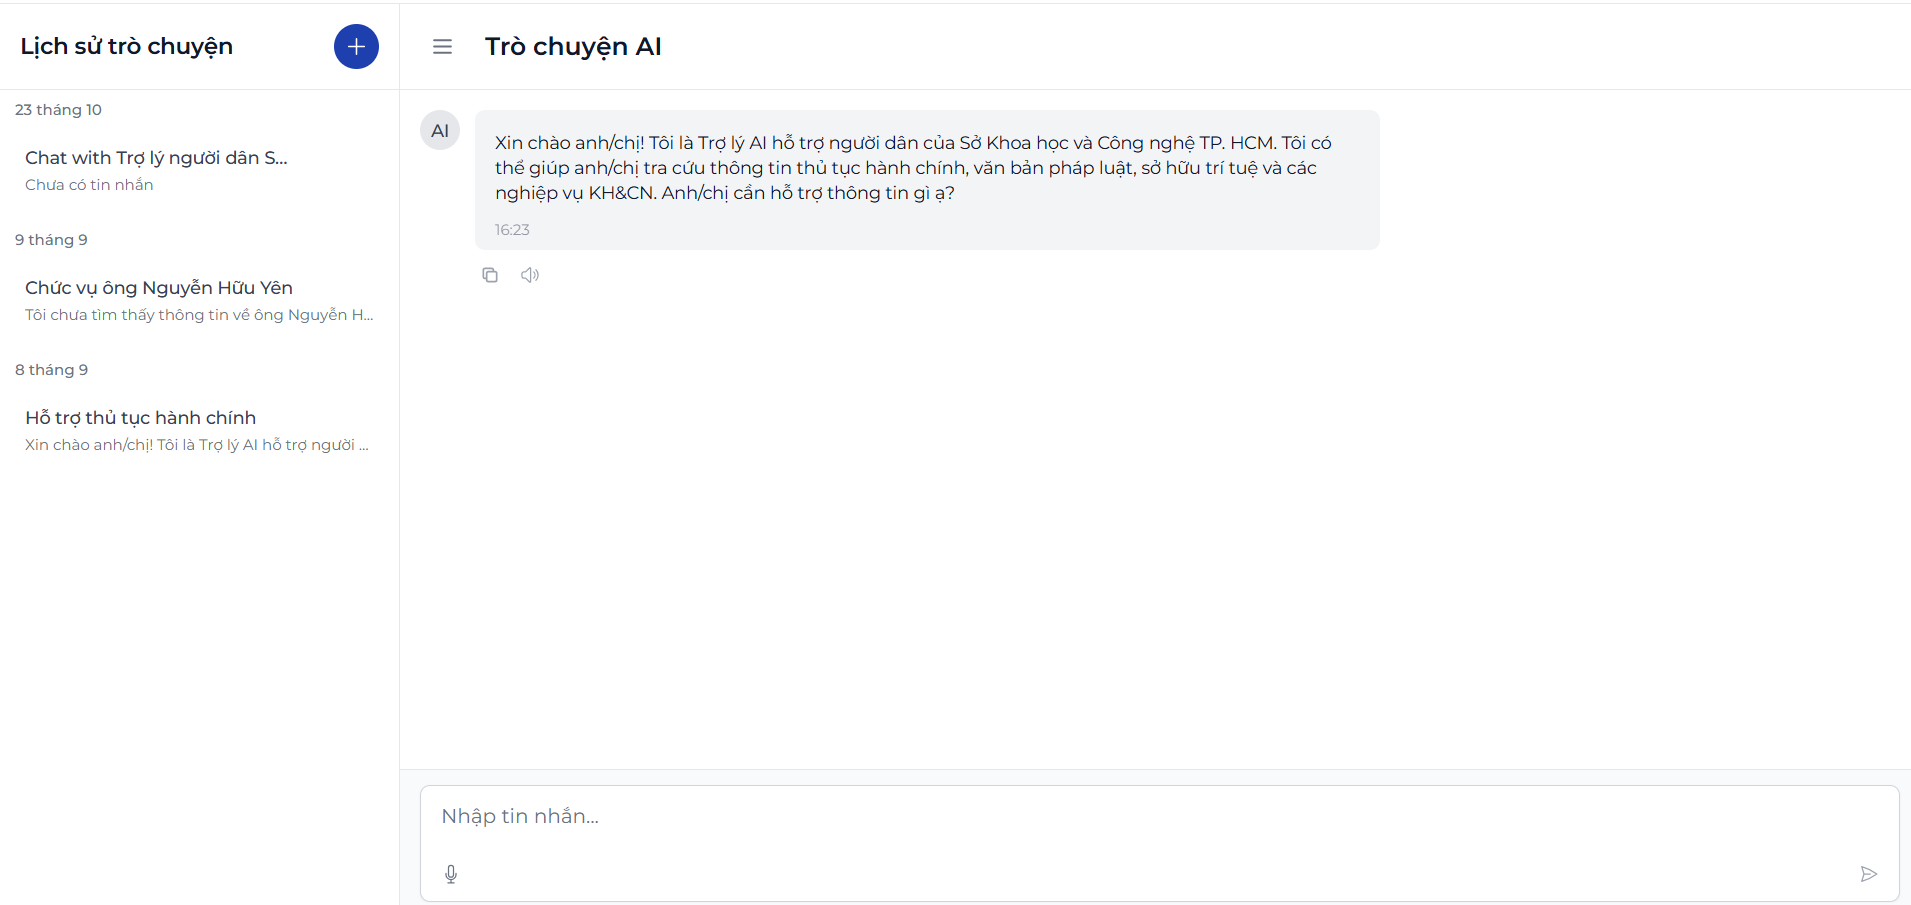
Giao diện người dùng của chatbot
Giải pháp được triển khai thử nghiệm tại Sở Khoa học và Công nghệ TP. Hồ Chí Minh với đối tượng thụ hưởng bao gồm người dân, doanh nghiệp và công chức, viên chức nội bộ. Hệ thống đã phục vụ hơn 150 người dùng với 2.847 phiên hội thoại và 8.532 lượt trao đổi. Chất lượng câu trả lời của chatbot dịch vụ công đạt điểm trung bình 4,20/5 qua đánh giá 300 câu kiểm thử, trong đó 78,7% đạt mức tốt. Module hỗ trợ công chức sinh văn bản hành chính (công văn, báo cáo, tham luận) đạt độ chính xác định dạng trên 90% với thời gian phản hồi trung bình chỉ từ 8-90 giây tùy độ phức tạp. Công nghệ OCR tự phát triển đạt 83,1 điểm (olmOCR Benchmark) và STT đạt tỷ lệ lỗi từ (WER) thấp ở mức 5,83%. Tỷ lệ người dùng đánh giá tích cực phiên bản cải tiến đạt 74% đến 81%.
Về mức độ nhân rộng và lan tỏa, dự án xây dựng một nền tảng lõi có tính module hóa cao. Việc cung cấp đầy đủ các chuẩn kết nối như REST API, GraphQL và giao diện Widget nhúng giúp hệ thống có thể dễ dàng được triển khai sang các cơ quan nhà nước, các sở ban ngành khác mà không yêu cầu xây dựng lại hạ tầng. Cơ chế cập nhật tri thức thông minh chỉ tinh chỉnh các phần dữ liệu bị ảnh hưởng khi có văn bản pháp luật mới ban hành, đảm bảo hệ thống luôn bắt kịp thay đổi thực tiễn.
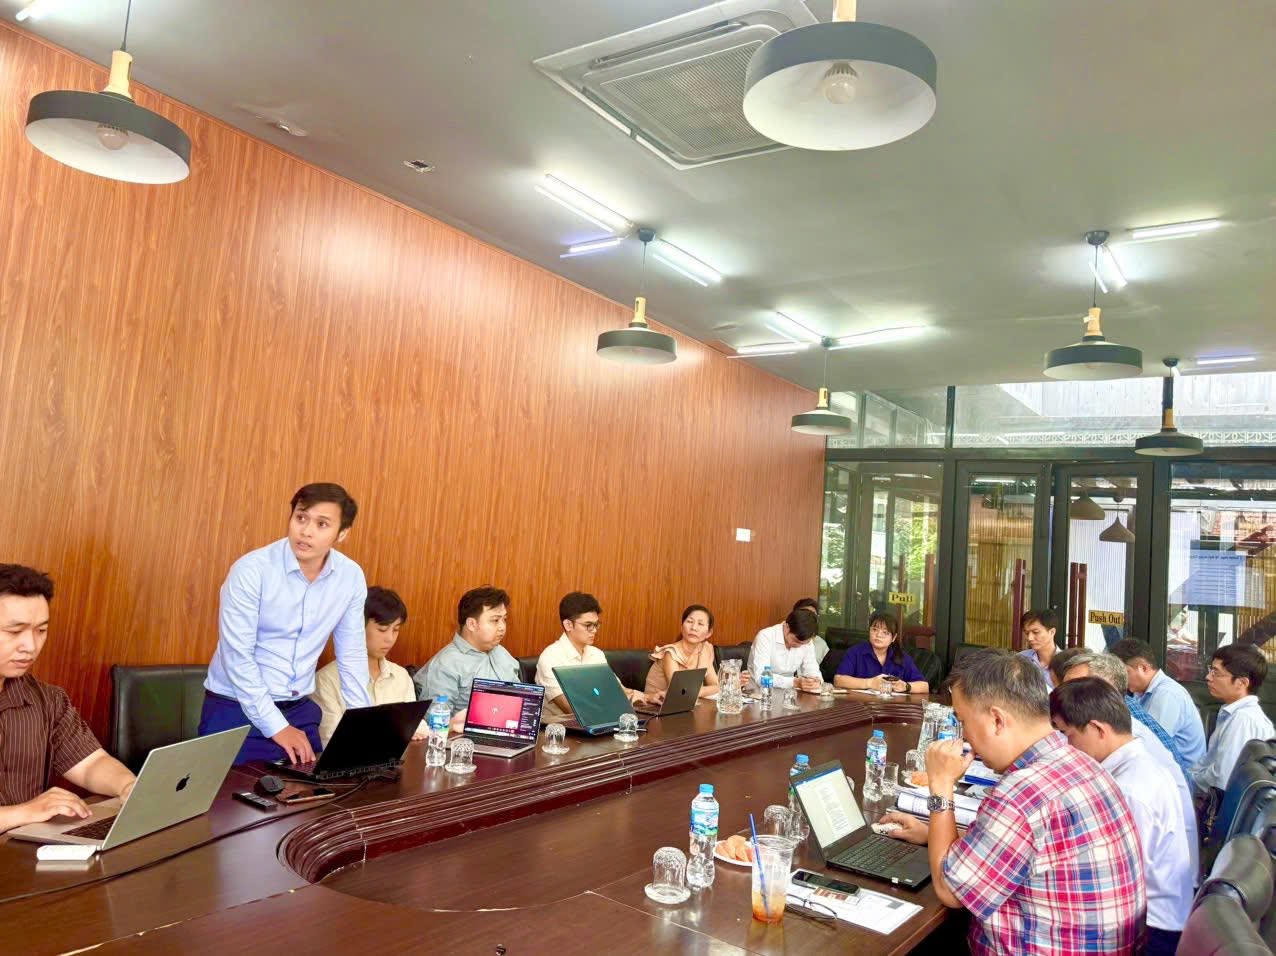
Hình ảnh nghiệm thu giải pháp
Năng lực thực hiện và tính bền vững của dự án được đảm bảo bởi liên danh giữa Đại học Kinh tế Thành phố Hồ Chí Minh và Công ty Cổ phần Công nghệ Promete, tận dụng tối đa năng lực nghiên cứu học thuật và hạ tầng công nghệ lõi. Rủi ro về bảo mật thông tin được kiểm soát chặt chẽ thông qua kiến trúc cô lập dữ liệu nội bộ và công khai, cơ chế phân quyền RBAC (Role-Based Access Control) đa realm và chuẩn mã hóa AES-256. Quá trình xử lý dữ liệu nhạy cảm được thực hiện hoàn toàn trên hạ tầng tự lưu trữ (self-hosted) với các công cụ nội bộ như STT và OCR tự phát triển, bảo vệ tuyệt đối chủ quyền dữ liệu của cơ quan nhà nước, tạo nền tảng vững chắc để tiếp tục phát triển các phiên bản nâng cao trong tương lai.
Công ty Cổ phần Công nghệ Promete